
Arquitectura de datos Transformación Digital

Arquitecturas de ingesta en Databricks: de cargas batch a Lakeflow Connect

89148

Cada fuente de datos implica credenciales, mecanismos de integración, monitoreo y lógica propios. Cuando una organización tiene decenas de fuentes bases de datos, aplicaciones SaaS, archivos en la nube, mantener esa integración a mano se vuelve, rápidamente, el verdadero cuello de botella de la ingeniería de datos. Este artículo repasa cómo Databricks resuelve ese problema, desde los métodos más simples para traer archivos hasta la ingesta administrada de sistemas empresariales completos con Lakeflow Connect.

3 Key Points

Databricks ofrece tres métodos de ingesta de archivos

CTAS, COPY INTO y Auto Loader según volumen y escenario.

Lakeflow Connect administra la ingesta de bases de datos, SaaS y ERP/CRM

sin código propio, con integración nativa a Unity Catalog.

Conectar una tabla bien exige definir cómo detectar cambios

identificarlos por PK y cómo representarlos en destino.

Ingesta desde almacenamiento en la nube

El punto de partida más común es traer archivos —CSV, JSON, XML, Parquet— desde Amazon S3, Azure Data Lake Storage o Google Cloud Storage, y convertirlos en tablas Delta listas para análisis. Databricks ofrece tres mecanismos para esto, cada uno pensado para un escenario distinto:

MétodoProcesamientoReprocesa archivosEscenario recomendado
CTASBatchSíCargas iniciales
COPY INTOIncremental BatchNoCargas incrementales programadas
Auto LoaderIncremental Batch / StreamingNoGrandes volúmenes y procesamiento continuo
9910

COPY INTO es un comando SQL puro para cargas incrementales e idempotentes: procesa solo archivos nuevos, sin generar duplicados, y mantiene automáticamente el historial de lo ya procesado a diferencia de CTAS, que vuelve a leer todo cada vez. Es ideal cuando el volumen de archivos es moderado y el equipo trabaja principalmente en SQL.

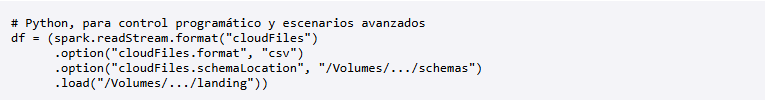
Auto Loader es el mecanismo recomendado para proyectos nuevos. Usa una fuente especial llamada cloudFiles una extensión de Structured Streaming que detecta automáticamente archivos nuevos, evoluciona el esquema, y administra el progreso mediante checkpoints (RocksDB) para garantizar procesamiento exactly-once. Soporta CSV, JSON, XML, Parquet, Avro, ORC, TXT y binarios, incluso comprimidos, y escala a millones de archivos. Se puede construir de dos formas:

Captura de pantalla 2026 09 15 073625
Captura de pantalla 2026 09 15 073651

Más allá del almacenamiento en la nube

CTAS, COPY INTO y Auto Loader resuelven la ingesta basada en archivos, pero gran parte de los datos empresariales vive en otro lugar: bases de datos relacionales (SQL Server, Oracle, PostgreSQL…), aplicaciones SaaS (Salesforce, Workday, ServiceNow…) y sistemas ERP/CRM (Dynamics 365, NetSuite, SAP…). Para eso existe Lakeflow Connect.

Lakeflow Connect: ingesta administrada para fuentes empresariales

Sin un servicio como este, conectar cada sistema implica escribir código JDBC propio, gestionar autenticación manualmente, resolver cargas iniciales ad-hoc, controlar la evolución de esquemas, programar reintentos y checkpoints, orquestar todo, y escalar la infraestructura y el mantenimiento de APIs por cuenta propia. Lakeflow Connect administra la extracción —no reemplaza la lógica de negocio ni las transformaciones— y aporta:

  • Low-code: configuración point-and-click o vía API.
  • Totalmente administrado: Databricks gestiona la infraestructura.
  • Integración con Unity Catalog: credenciales y permisos centralizados.
  • Ingesta incremental: solo se procesan datos nuevos o cambiados.
  • Escalabilidad automática según el volumen.
  • Conectores nativos para SaaS y bases de datos empresariales.

Cuando no existe un conector nativo, o se requieren capacidades más especializadas, Databricks integra soluciones de terceros a través de Partner Connect (Fivetran, Informatica, Qlik, Rivery, Alteryx, Prophecy), aunque esto puede implicar licencias y costos adicionales, y el nivel de integración con Unity Catalog varía según el proveedor.

9501

Cómo fluyen los datos desde una base de datos

Las bases de datos suelen vivir en redes privadas, así que el flujo requiere componentes adicionales para garantizar conectividad y aislamiento: un Ingestion Gateway se autentica contra la base, hace la lectura inicial (snapshot) y captura los cambios (CDC); un Volume de Unity Catalog sirve de área de staging, desacoplando la extracción del procesamiento y guardando checkpoints; y una ingesta administrada serverless lee ese staging, procesa y sincroniza los datos hacia tablas Delta en streaming.

Tres preguntas antes de conectar una tabla

Configurar correctamente una fuente requiere responder tres cosas: ¿cómo detecto filas nuevas o modificadas? (cursor o mecanismo CDC), ¿a qué fila existente corresponde ese cambio? (primary key) y ¿cómo represento el cambio en el destino? (SCD Type 1, Type 2 o Append-only). Son decisiones que forman una estrategia conjunta, no elecciones aisladas.

Una guía rápida para decidir

Pregunta Camino sugerido
¿Existe un Managed Connector para la fuente? Empieza por ahí.
¿Necesitas baja latencia o cambios frecuentes? Prefiere CDC si el conector lo soporta.
¿No puedes habilitar CDC? Evalúa Query-Based con un cursor confiable.
¿Necesitas lógica de extracción muy particular? Evalúa Partner Connect, Lakeflow Pipelines o Structured Streaming.
¿La base de datos está en red privada? Evalúa conectividad y componentes de gateway requeridos.

El nivel de administración, el mecanismo de incrementalidad y la conectividad de red se evalúan siempre juntos: no son decisiones independientes, sino parte de una misma estrategia de ingesta.

Si quieres ver todo esto explicado con ejemplos en vivo, puedes revisar la grabación de nuestro webinar «Ruta LakeFlow: Ingesta de datos, conecta tus fuentes», con Carlos Rodríguez, Ingeniero de Datos en DataKnow míralo aquí.